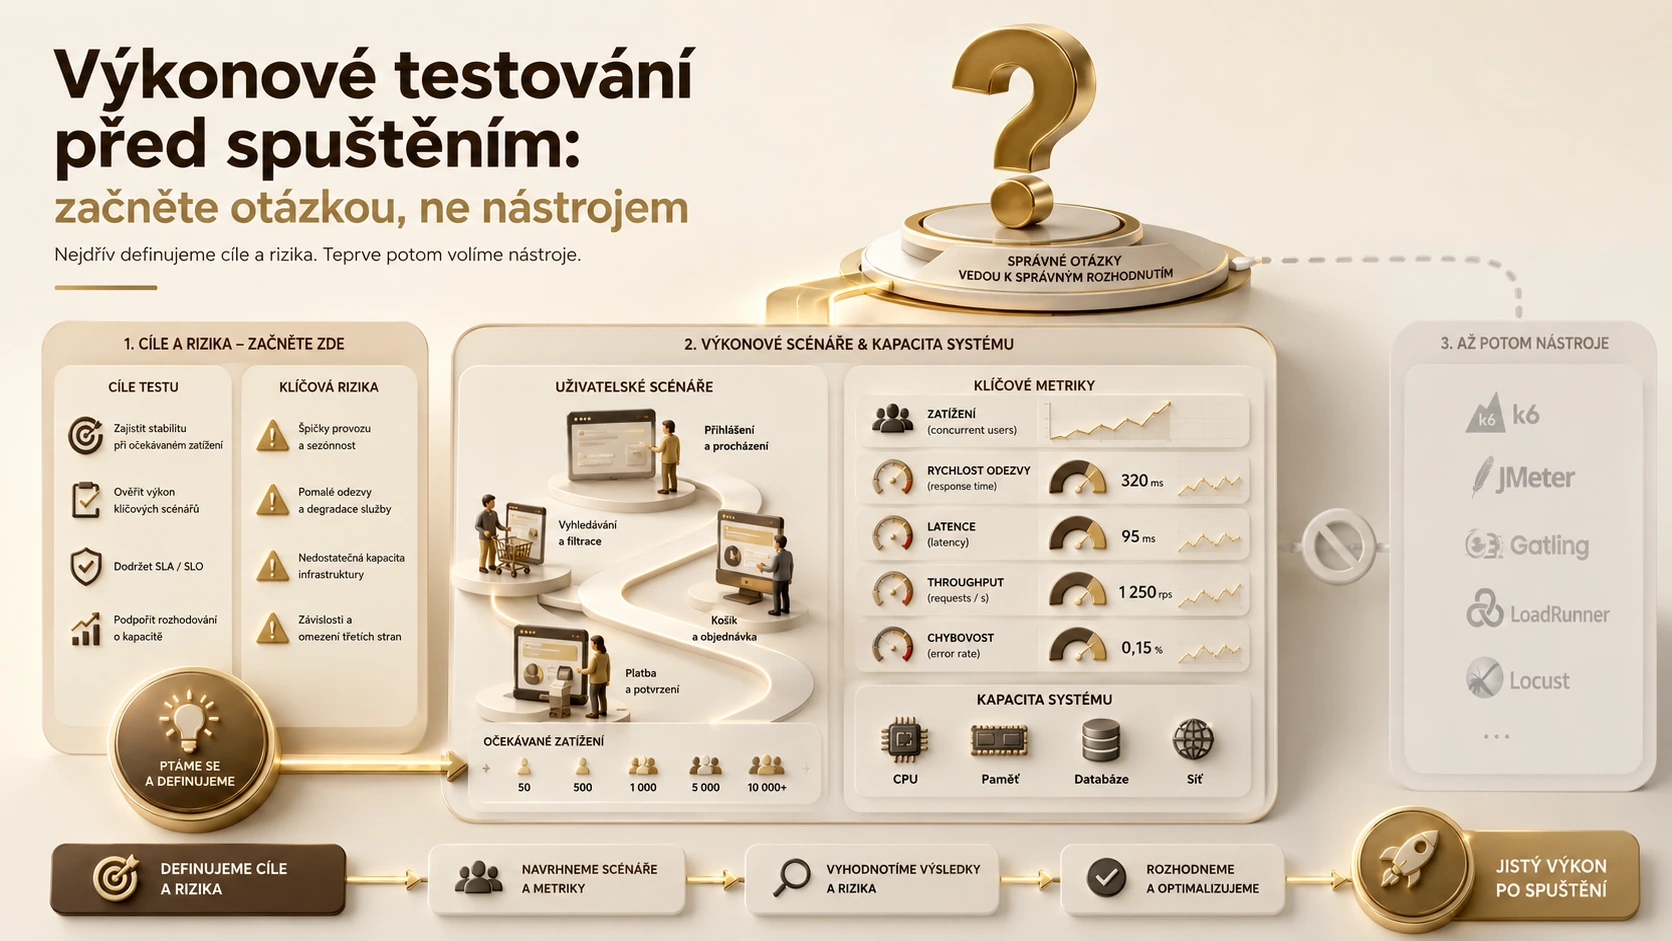
Výkonové testování před spuštěním bych začala obchodní otázkou: kterou činnost musí systém zvládnout a co se stane, když ji nezvládne včas? Počet virtuálních uživatelů sám o sobě odpověď nedává. Dva systémy se stejným počtem přihlášených lidí mohou zpracovávat úplně jiný objem práce. Rozhodující je kombinace operací, jejich četnost, velikost dat a souběh. Smyslem testu je získat podklad pro rozhodnutí o připravenosti, ne pouze vytvořit graf, který během krátké ukázky vypadá příznivě.
Skutečný případ: migrace TSB ve Spojeném království
Britští regulátoři FCA a PRA oznámili 20. prosince 2022 sankce vůči TSB za selhání řízení provozních rizik při změně informační platformy. Podle zprávy FCA následovaly po migraci v dubnu 2018 technické problémy a narušení bankovních služeb ve Spojeném království. Tento případ nepopisuji jako důkaz jediné konkrétní chyby ve výkonovém testu. Jeho poučení pro můj návrh je širší: úspěšný přenos dat není totožný s připraveností celé služby pro skutečné používání.
Z tohoto rozlišení bych odvodila rozsah testu. Vedle jednotlivé odpovědi aplikace bych chtěla sledovat dokončení celé obchodní činnosti, například odeslání žádosti a její následné zpracování. Krátká odpověď, která pouze přijme práci do fronty, může působit dobře, i když samotný výsledek vzniká se značným zpožděním. V dokumentaci bych proto rozlišila přijetí požadavku, jeho technické dokončení a okamžik, kdy má uživatel skutečně použitelný výsledek. Každý z těchto časů může podporovat jiný závěr o kvalitě služby.
Jak bych sestavila zátěž
Nejdříve bych popsala běžný den, očekávanou špičku a neobvyklý, ale relevantní souběh. Zdrojem předpokladů může být dostupný provozní přehled nebo jasně označený odhad pro novou službu. U odhadu bych zaznamenala nejistotu a navrhla více variant. Scénář musí zahrnovat pomalejší i rychlejší uživatele, různé velikosti souborů a činnosti, které soutěží o stejné prostředky. Všichni virtuální uživatelé pracující s jedním drobným záznamem by mohli testovat hlavně účinnost mezipaměti, nikoli zamýšlený provozní profil nové aplikace.
Před spuštěním bych také prověřila samotný generátor zátěže. Pokud se vyčerpá jeho procesor nebo síť, výsledek může mylně vypadat jako hranice testovaného systému. Potřebovala bych vědět, kolik požadavků bylo plánováno, skutečně odesláno, přijato a dokončeno. Rozdíly mezi těmito počty pomáhají najít místo omezení. Zaznamenala bych nastavení testu, verzi aplikace a relevantní konfiguraci. Bez této stopy může být další měření nepoužitelné pro srovnání, přestože používá stejný název scénáře a stejný nástroj.
Hypotetický příklad importní kampaně
Představme si modelovou aplikaci, která má během hodiny přijmout 500 souborů a současně umožnit editaci běžným uživatelům. Pro příklad si stanovme cíl: alespoň 95 % editací dokončit do dvou sekund a všechny přijaté soubory zpracovat do třiceti minut po skončení náporu. Jde o hypotetické požadavky, nikoli obecně platné prahy. Test bych rozdělila podle velikosti souborů a přidala souběžný reporting. Průměrná odezva sama nestačí, protože může zakrýt menší skupinu uživatelů s velmi dlouhým čekáním.
Uvažujme, že systém přijme soubory rychle, ale během testu roste fronta a po skončení hodiny se vyprazdňuje další dvě hodiny. Technická dostupnost vstupního rozhraní tedy neznamená splnění uvedeného obchodního cíle. Hledala bych omezení v navazujícím zpracování, například čekání na databázi nebo externí závislost. Před návrhem změny bych potřebovala měření, které příslušnou hypotézu podporuje. Pouhé zvýšení počtu pracovníků může přetížit společný prostředek a situaci zhoršit. Nápravu bych proto znovu ověřila stejným základním profilem a srovnatelnými daty.
Délka testu a chování po špičce
Krátký test může ověřit okamžitou kapacitu, ale nemusí zachytit pomalé vyčerpávání prostředků. Navrhla bych proto podle povahy služby delší běh se stabilní zátěží. Sledovala bych paměť, otevřená spojení, velikost front a vývoj časů v průběhu běhu. Pokud se odezva zhoršuje až později, průměr za celý test může příčinu skrýt. Zajímaly by mě oddělené časové úseky a stav po zastavení generátoru. Systém, který po skončení špičky dlouho nedokončí rozpracovanou práci, potřebuje jiné posouzení než systém s rychlým zotavením.
Vyzkoušela bych také řízené omezení závislosti, pokud to prostředí dovoluje. Nejde o libovolné vypínání součástí, ale o předem připravený experiment s jasným rozsahem. Chci vědět, jak aplikace zachází s čekáním, opakováním a odmítnutím nové práce. Opakovaný požadavek nesmí v modelovém obchodním procesu vytvořit dva výsledky jen proto, že uživatel nedostal první odpověď. Výkon tak souvisí i se správností a obnovou. Přijatelná odezva při chybné nebo duplicitní operaci není úspěšný výsledek připravenosti služby.
Co bych předala rozhodujícímu týmu
Výsledný přehled by obsahoval cíle, skutečně provedené scénáře, odchylky prostředí a omezení interpretace. Pokud testovací databáze obsahuje méně dat než plánovaná produkce, popsala bych důsledky pro závěr. Nesnažila bych se mechanicky násobit dosaženou kapacitu poměrem procesorů bez důkazu, že takové škálování platí. Jasně bych uvedla, které situace test pokryl a které zůstávají neověřené. Rozhodnutí může přijmout určitou nejistotu, ale potřebuje ji vidět a spojit s konkrétním provozním opatřením nebo dalším ověřením.
U každého zjištění bych navrhla vlastníka a ověřovací krok. Oprava dotazu, změna limitu a změna způsobu zpracování mají různé vedlejší účinky. Po úpravě bych neověřovala jen původně pomalou operaci, ale také činnost, se kterou sdílí prostředky. Zrychlení importu může například prodloužit editaci uživatelů. V závěrečném porovnání bych proto použila stejné obchodní cíle. Úspěch má být vidět v uživatelském výsledku a schopnosti systému dokončit práci, ne pouze v lepším dílčím grafu jednoho technického ukazatele.
Příprava provozní reakce
Před rozhodnutím o spuštění bych prošla také reakci na překročení ověřené kapacity. Kdo pozná rostoucí frontu, kdo může omezit méně důležitou práci a podle čeho poznáme návrat k běžnému stavu? Testovací výsledek může pomoci tyto podmínky konkretizovat. Pokud provozní tým nevidí stejné ukazatele jako během testu, bude se mu obtížně používat získané poznání. Navrhla bych proto ověřit dostupnost potřebného monitoringu a srozumitelnost upozornění před předáním služby do běžné správy.
Součástí předání by byl také postup při neúplné operaci. Uživatel potřebuje rozlišit, zda má čekat, zopakovat požadavek nebo vyhledat pomoc. Nejasná zpráva může vyvolat další zátěž opakovaným klikáním a současně ztížit dohledání původní práce. V modelovém testu bych proto sledovala i tuto zpětnou vazbu. Ověřila bych, zda stavová zpráva odpovídá skutečnému stavu zpracování a zda pracovník podpory dokáže dohledat konkrétní požadavek. Připravenost služby zahrnuje schopnost vysvětlit výsledek člověku, který jej právě potřebuje.
U významného omezení bych stanovila také podmínku dalšího přetestování. Změna objemu dat nebo důležité závislosti může zúžit platnost původního výsledku, i když samotný aplikační kód zůstal stejný.
Shrnutí a doporučení
Doporučila bych začít měřitelným cílem služby, připravit realistický souběh a monitorovat celý tok práce. Oddělit přijetí a dokončení, kontrolovat generátor zátěže a zachovat podmínky pro opakování. Delší běh a sledování zotavení pomohou odhalit problémy, které krátká špička neukáže. Případ TSB připomíná význam celkové provozní připravenosti; nenahrazuje vlastní důkazy pro nový systém. Rozhodnutí o spuštění bych opřela o srozumitelný souhrn toho, co test potvrdil, co selhalo a jaká nejistota po ověření zbývá.