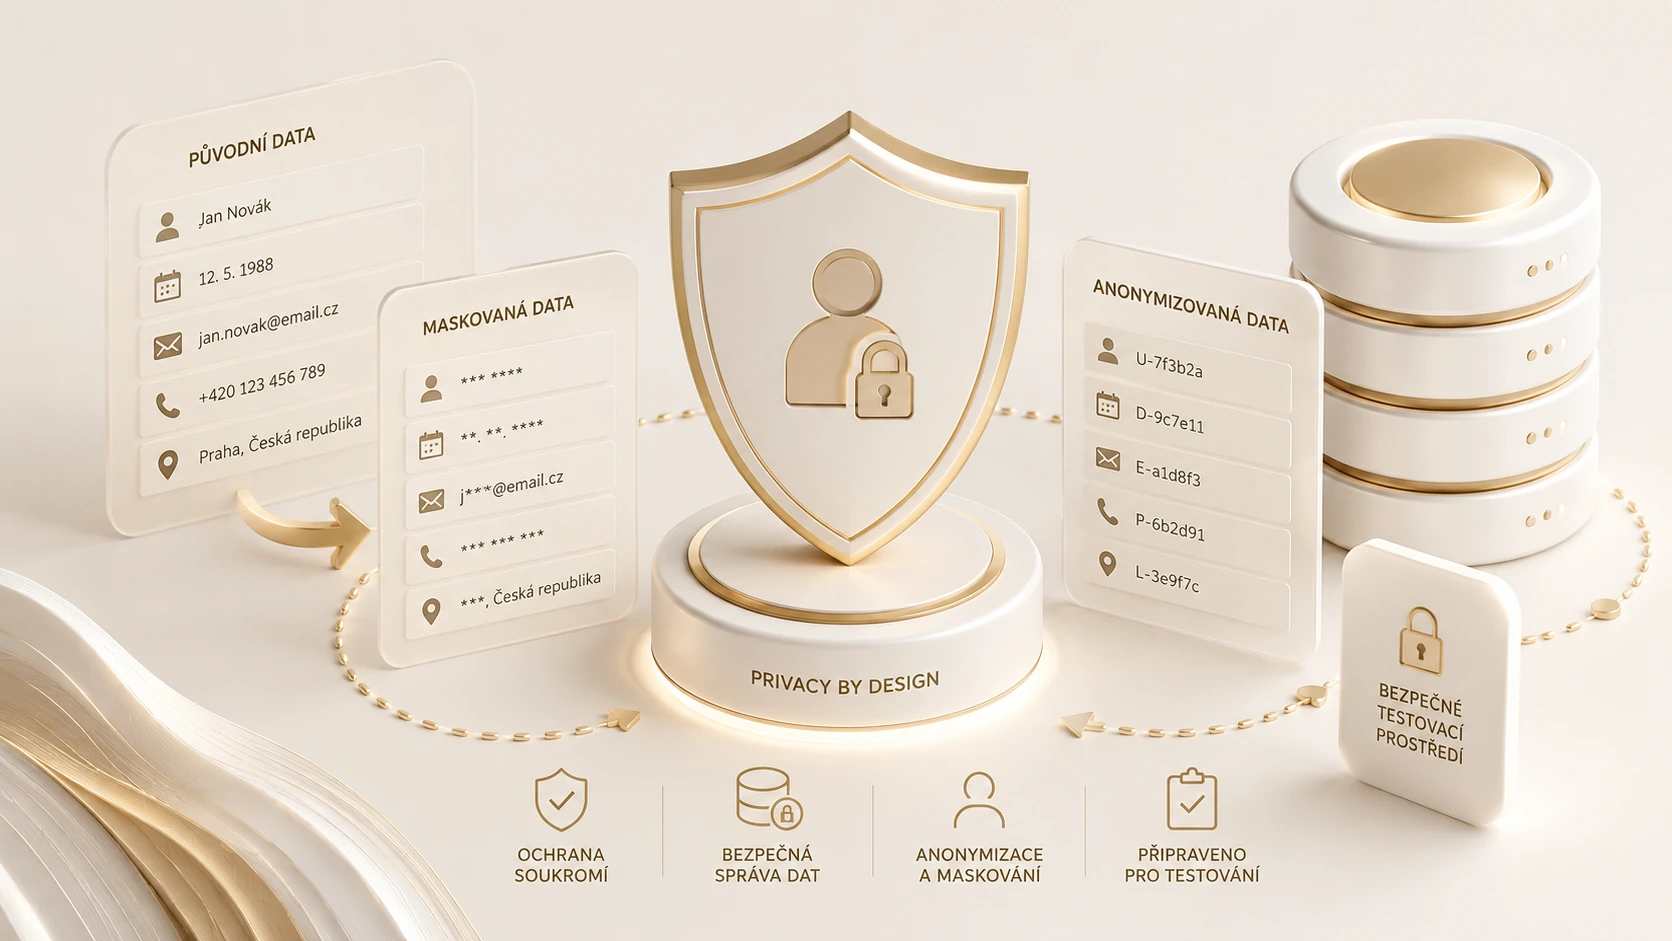
Testovací data mají připomínat skutečný provoz, aby odhalila skutečné chyby. Z toho však neplyne, že nejlepší řešení je zkopírovat produkční databázi. V takové kopii se mohou vedle potřebných vazeb objevit jména, kontakty, platební historie nebo údaje, které pro konkrétní test nepotřebujeme. Nejde jen o bezpečnost databáze: data mohou pokračovat do logů, příloh úkolů, snímků obrazovky a záloh. Při návrhu testu bych proto současně řešila jeho vypovídací hodnotu i rozsah informací, které skutečně potřebuje.
Skutečný případ: Advanced a odpovědnost dodavatele
Britský ICO oznámil 26. března 2025 pokutu 3,07 milionu liber společnosti Advanced Computer Software Group za bezpečnostní nedostatky ohrožující informace 79 404 lidí. Firma poskytovala IT služby mimo jiné zdravotnickým organizacím. Oficiální záznam ICO nepředkládám jako případ úniku z testovací databáze. Je doloženým příkladem rizika u zpracovatele; souvislost s testovacím prostředím je moje preventivní úvaha.
Pro mě z toho vyplývá otázka: umíme doložit, kde všude má dodavatel naše údaje a jaký účel každá kopie plní? Neodvozovala bych z jedné události, že externí prostředí je vždy nebezpečné. Prověřila bych však pravidla přístupů, způsob předávání souborů a odpovědnost za odstranění. Dohoda, že jde pouze o test, sama o sobě nevysvětluje, proč má uživatel přístup k celé historii klienta. Stejně důležité je vědět, co se stane po ukončení spolupráce.
Realističnost není totéž co totožnost
Test může potřebovat dlouhé příjmení, prázdnou hodnotu, neobvyklý znak nebo vazbu několika smluv na jednoho klienta. Zpravidla nepotřebuje konkrétní příjmení skutečného člověka. Rozlišovala bych technický formát, statistickou vlastnost a obchodní vztah. Pro import je zásadní délka a kódování pole; pro segmentaci rozložení kategorií; pro report stabilní identifikátory a vazby. Každý z těchto požadavků lze popsat, aniž bychom automaticky přenesli původní identitu. Výjimku bych zdůvodnila konkrétní potřebou testu.
Pouhé nahrazení jmen nestačí, pokud člověka umožní poznat kombinace obce, věku, zaměstnavatele a unikátní události. Pseudonymizovaný soubor proto nepovažuji automaticky za anonymní. O skutečné anonymitě bych chtěla odborné posouzení podle konkrétní situace. Pro svou analytickou práci mohu především omezit výběr sloupců a počet záznamů a popsat účel použití. Tím pomohu zmenšit problém dříve, než bude nutné řešit jeho složitější právní a bezpečnostní stránku.
Modelový příklad: regresní sada bez celé databáze
Následující příklad je hypotetický. Potřebuji ověřit import 100 000 klientských záznamů a správný počet aktivních smluv. Malá funkční sada může obsahovat 30 syntetických klientů: jednotlivce bez smlouvy, klienta s více smlouvami, ukončenou smlouvu, chybějící kontakt, duplicitu a různé formáty jmen. Pro výkon vytvořím 100 000 dalších syntetických záznamů se stejnou strukturou. Identifikátory budou vygenerované, ale referenční vazby zůstanou platné. Očekávané počty si vypočtu před spuštěním, nikoli podle výsledku aplikace.
Záměrně vložím také pět neplatných vazeb a tři duplicity. Test má ukázat, zda systém chybu odmítne, označí nebo opraví podle schváleného pravidla. Pokud by anonymizační proces všechny neplatnosti automaticky vyčistil, přišla bych o důležité testovací situace. Dokumentace sady proto obsahuje nejen počet řádků, ale také význam připravených výjimek. Výkonová sada musí mít dostatečnou různorodost; opakování stejného řádku může díky vyrovnávací paměti vytvořit nerealisticky příznivý výsledek.
Jak bych nastavila datovou cestu
Začala bych seznamem testovacích otázek a přiřadila k nim nutná pole. Potom bych navrhla způsob vytvoření dat a ověřila, že zachovává vztahy, na kterých aplikace rozhoduje. Před prvním použitím bych s vlastníkem dat a bezpečnostním týmem potvrdila přístupová oprávnění, povolená prostředí a dobu uchování. Zapsala bych, kdo sadu vytvořil, jakou verzí generátoru a s jakými parametry. Změna generátoru je změnou testovacího podkladu a zaslouží stejnou pozornost jako změna očekávání.
Zvlášť bych ověřila odchozí kanály. Testovací e-mail nebo telefonní číslo nesmí omylem vést skutečnému zákazníkovi. Platební a komunikační integrace bych směřovala do vhodných testovacích režimů nebo bezpečných náhrad. Přístupový token patří mezi citlivé informace stejně jako obsah záznamu; jeho přítomnost ve vzorovém exportu je samostatný problém. Před předáním souboru bych také zkontrolovala skryté listy tabulky, komentáře a připojené přílohy. Název souboru „anonymní“ není důkazem jeho bezpečnosti.
Důkazy o chybě mají obsahovat jen potřebné
Do hlášení chyby bych přiložila nejmenší ukázku umožňující problém zopakovat. Pokud stačí identifikátor testovacího záznamu a očekávaný počet, není důvod vkládat celý export. U snímků obrazovky bych promyslela i otevřené záložky a okolní panel aplikace. U logů bych hledala, zda se tajné hodnoty nebo kontakty nepropíší v chybové zprávě. Bezpečné testování tedy nekončí přípravou databáze: zahrnuje také důkazy, které tester vytváří při každém nalezeném problému.
Odstraňování dat bych neřešila jen jednorázovým příkazem v databázi. Zajímalo by mě uchování v zálohách, exportech a lokálních složkách a kdo může potvrdit ukončení přístupu. U opakovaných testů může být praktičtější krátkodobě vytvářená sada než dlouhodobě spravovaná kopie. Případné selhání mazání bych evidovala jako kontrolní výjimku s vlastníkem a termínem, nikoli jako technickou drobnost bez dopadu.
Kontrola po skončení testu
Po skončení testu bych ověřila, zda nezůstaly další kopie v přílohách incidentů, exportech výsledků nebo lokálních pracovních složkách. Samotné smazání hlavní databáze totiž neodpovídá na otázku, kam se informace během práce dostala. Navrhla bych jednoduchý seznam povolených umístění, odpovědnost za jejich vyčištění a způsob ověření výsledku. U každé výjimky bych chtěla znát účel a dobu uchování. Takový postup by měl být proveditelný běžným týmem, jinak se z něj snadno stane pouze formulální závěrečný bod.
Při opravě chyby bych oddělila diagnostické údaje od obsahu, který k vysvětlení příčiny nepotřebujeme. Vývojář může potřebovat informaci o typu záznamu, pořadí operací nebo délce pole; nemusí automaticky potřebovat celý klientský dokument. Navrhla bych proto reprodukovat problém nejprve na zmenšeném syntetickém případu. Pokud se chyba projeví jen na určité kombinaci údajů, popsala bych tuto kombinaci a ověřila, zda ji lze vytvořit bez přenesení původní identity. Úspěšná reprodukce by pak sloužila zároveň jako podklad pro další kontrolu po opravě.
Pro pravidelné ověření bych vybrala konkrétní dokončený test a sledovala celý životní cyklus jeho dat od přípravy až po odstranění kopií. Takový průchod pomůže zjistit, zda stanovený postup funguje i při běžném časovém tlaku a předávání práce mezi lidmi.
Ověření proveditelnosti
Před zavedením postupu bych prošla jeden modelový test s lidmi, kteří jej mají používat. Zjistila bych, zda vědí, kde získat bezpečný datový soubor a komu předat nejasný případ. Pokud správná cesta není dostupná včas, samotná instrukce nestačí. Doporučení proto potřebuje také praktickou dostupnost schváleného řešení a jasnou odpovědnost za jeho údržbu.
Shrnutí a doporučení
Dobrý testovací soubor je ten, který spolehlivě odpoví na testovací otázku a současně obsahuje jen nezbytné informace. Doporučila bych začínat syntetickými daty, samostatně ověřovat vazby a výjimky a omezit kopírování skutečných údajů na zdůvodněné případy. U každé sady bych chtěla znát původ, účel, oprávněné uživatele a datum odstranění. Měřila bych také to, kolik chyb lze reprodukovat bez produkčních údajů. Taková metrika ukazuje praktický posun k bezpečnějšímu a opakovatelnému testování.