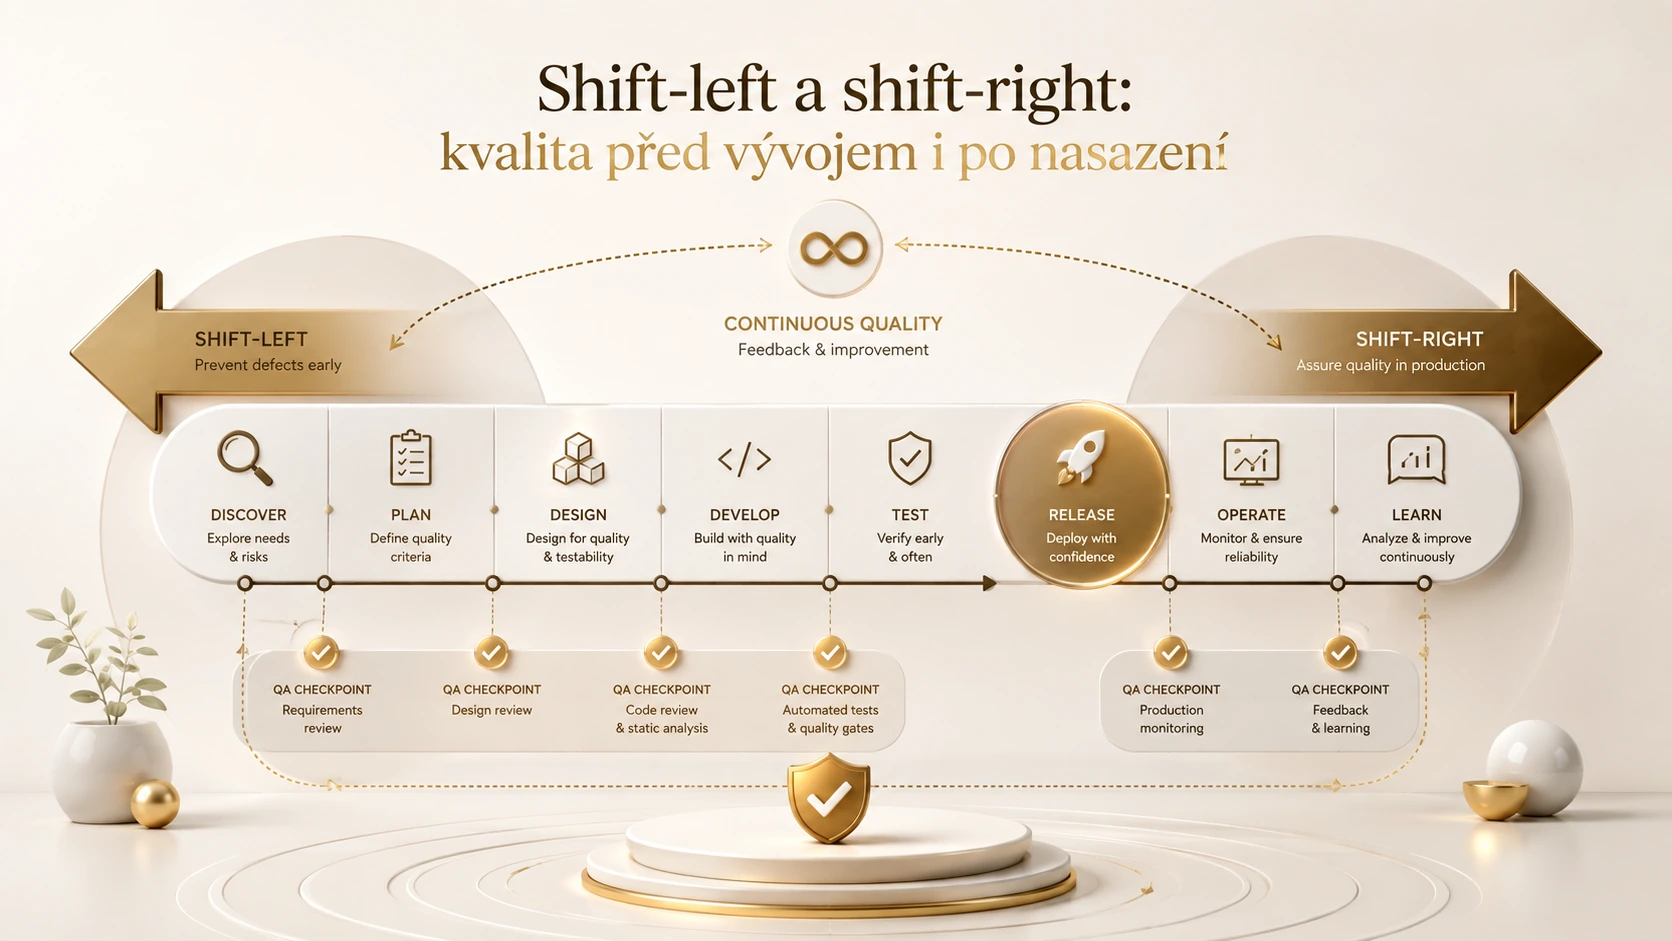
Kvalita potřebuje dvě časové perspektivy
Shift-left a shift-right popisují, kdy získáváme důkazy o kvalitě. V prvním případě klademe otázky a prověřujeme předpoklady už při přípravě požadavku, návrhu a vývoji. Ve druhém sledujeme skutečné chování služby po nasazení. Nejde o přesun veškerého testování na jeden konec. V mém navrženém přístupu se oba pohledy propojují do zpětné vazby mezi očekáváním a provozním výsledkem.
Brzká kontrola může odhalit nejasné pravidlo dříve, než podle něj vznikne několik navazujících komponent. Provozní pozorování zase ukáže závislost nebo objem, které testovací prostředí nezachytilo. Každý důkaz má vlastní rozsah. Úspěšný test neprokazuje bezchybnost každého skutečného vstupu a bezproblémový provoz během jedné hodiny nevypovídá automaticky o měsíční uzávěrce. Proto bych otázku „máme to otestované?“ nahrazovala přesnějším popisem ověřeného chování.
Skutečný případ: Cloudflare, globální síť, 2. července 2019
Cloudflare ve vlastním rozboru zveřejněném 12. července 2019 popsalo globální výpadek způsobený pravidlem webového aplikačního firewallu. Regulární výraz nadměrně zatížil procesory; mezi uvedenými slabinami byly chybějící výkonnostní kontrola a globální nasazení bez postupného rozšíření. [1] Jde o veřejně doložený incident, nikoli o zkušenost z mé vlastní práce nebo o modelovou banku.
Z případu si odvozuji potřebu propojit preventivní ověření s omezením dosahu změny a provozní detekcí. Ani velmi rychlý alarm neodstraní škodu, která vznikne před reakcí. Zároveň nelze předpokládat, že předprodukční zkouška zachytí každé chování. Navržené kontroly mají proto odpovídat konkrétnímu mechanismu: spotřebě prostředků, cestě nasazení, dosažitelnosti ovládání a schopnosti bezpečně změnu zastavit.
Modelový příklad: změna klientského oznámení
Představme si výhradně modelovou banku, která mění pravidlo pro zasílání oznámení o splátce. Nově se má zpráva vytvořit tři pracovní dny před splatností. Již při zadání bych otevřela otázku svátků, časového pásma, změny splatnosti a opakovaného běhu dávky. Pokud se tyto otázky odloží na konec vývoje, různé týmy si mohou stejnou větu vyložit různě.
Modelová provozní nejistota je jiná: i správně vytvořená zpráva může uvíznout u dodavatele nebo být znovu odeslána po opakování požadavku. Proto bych vedle pravidla výpočtu termínu navrhla sledovat také počet unikátních zpráv, jejich stáří a potvrzení předání. Uvedené kontroly nejsou popisem skutečné banky a konkrétní hranice by musel určit vlastník služby podle potřeb klientů a provozních možností.
Co bych ověřovala před vývojem
Začala bych několika konkrétními příklady. Pro stejnou splatnost bych nechala odpovědné lidi určit očekávaný den vytvoření oznámení za různých kalendářních podmínek. Nešlo by jen o materiál pro pozdější automatický test. Příklady mají odhalit neshodu v samotném pravidle. Pokud obchodní vlastník a vývojář očekávají jiný výsledek, potřebujeme rozhodnutí, nikoli rychlejší implementaci nejasnosti.
Dále bych popsala hranice odpovědnosti mezi systémy. Který systém rozhoduje o termínu, který o obsahu a který o doručení? Co znamená stav „odesláno“? Přijetí požadavku dodavatelem a doručení klientovi nemusí být stejná událost. Přesné pojmy jsou součást kvality, protože ovlivňují testy, obrazovky podpory i interpretaci provozních ukazatelů. Bez nich může každý tým vykazovat úspěch z jiné části cesty.
Jak bych připravovala zkoušky
Testovací sadu bych odvodila od rizikových cest a hranic, ne pouze od obrazovek. Zahrnula bych správný průchod, chybějící údaj, změnu splatnosti a opakované zpracování. U opakování je podstatné, zda stejná obchodní událost vytvoří druhé oznámení. Automatizace má smysl tam, kde opakovaně ověřuje stabilní pravidlo; nenahradí však rozhodnutí o tom, co má být správný výsledek.
Vedle funkce bych zkoumala provozní předpoklady. Při měsíční špičce může mít dávka násobně větší objem než během běžného dne. Potřebovala bych proto vědět, jak vznikl testovací objem a zda odpovídá očekávané zátěži. Citlivá klientská data bych nepřenášela do testu jen kvůli realismu. Reprezentativnost má stát na relevantních vlastnostech a vazbách, s přiměřenou ochranou údajů a řízeným přístupem.
Co bych sledovala po nasazení
Pro modelová oznámení bych spojila technickou dostupnost s obchodním výsledkem. Běžící proces ještě neznamená, že vznikly všechny očekávané zprávy. Počet připravených událostí bych porovnávala s počtem jednoznačně předaných zpráv, včetně vysvětlených výjimek. Současně bych sledovala stáří čekajících položek. Malá fronta může být závažná, pokud obsahuje zprávy, jejichž termín už nelze splnit.
Alarm by měl mít vlastníka a popsanou reakci. Bez nich je monitoring pouze produkce dalších informací. V modelovém případě by provoz potřeboval rozlišit zpoždění dodavatele od chyby výpočtu termínu, protože pouhé opakování dávky může vytvořit duplicity. Google SRE nabízí jako další čtení vysvětlení provozního sledování. [2] Uvedené principy bych vždy převáděla na konkrétní klientskou službu a její omezení.
Omezit dosah a zachovat možnost zásahu
Pokud to architektura umožňuje, navrhla bych postupné rozšíření změny s předem určenými zastavovacími podmínkami. Malý vzorek však nesmí vytvořit falešnou jistotu: musí obsahovat relevantní varianty, například různé kalendáře nebo starší smlouvy. Náhodně vybraných několik jednoduchých případů může přehlédnout přesně tu cestu, která je pro změnu nejnáročnější. Omezení dosahu a reprezentativnost se proto posuzují společně.
Předem bych také ověřila, jak se zásah provede během poruchy. Když je ovládací nástroj závislý na stejném systému, který selhal, může být návratový plán jen teoretický. Potřebujeme dostupná oprávnění, ověřený postup a srozumitelný rozhodovací bod. Výjimky z běžného přístupu mají být řízené; řešením není trvale oslabit ochrany, ale připravit oprávněnou a vyzkoušenou cestu pro mimořádnou situaci.
Vrátit poznatek do zadání
Pokud provoz ukáže neočekávané opakování oznámení, doplnila bych příklad do specifikace a testů. Současně bych zkoumala, zda stejný předpoklad neovlivňuje další zprávy. Zpětná vazba má změnit budoucí rozhodování, ne pouze uzavřít jeden incident. Užitečné je zachovat popis mechanismu, aby se tým neomezil na konkrétní identifikátor transakce, na němž se problém náhodou projevil.
Shrnutí a doporučení
Doporučila bych začít ověřitelnými příklady už při zadání, propojit je s testy a doplnit provozní signály skutečného výsledku. Každá významná nejistota potřebuje vlastníka a přiměřenou ochranu. Shift-left snižuje počet problémů přenesených do implementace; shift-right ověřuje předpoklady v reálných podmínkách. Hodnotu přináší jejich spojení, včetně úpravy specifikace podle doložených poznatků z provozu.
Jak bych rozlišila poznatek od domněnky
Při přenosu provozního problému do testování bych nejprve zachovala přesné podmínky výskytu. Samotná věta, že se zpráva odeslala dvakrát, neurčuje mechanismus. Potřebujeme časové pořadí požadavků, jednoznačný identifikátor obchodní události a dostupné záznamy odpovědí. Bez nich může tým vytvořit test, který sice projde, ale původní situaci vůbec nereprodukuje. Neúplnou hypotézu bych proto viditelně označila a doplnila plán jejího ověření.
Za důležitou považuji i odpovědnost za propojení obou stran. Testovací tým může přidat scénář, provoz může upravit alarm a obchodní vlastník změnit pravidlo, ale společně potřebují potvrdit, že stále sledují tentýž výsledek. Krátká společná revize vazby mezi očekáváním, testem a provozním ukazatelem by v mém návrhu zabránila tomu, aby se jednotlivé opravy rozešly. U složitější změny bych tuto vazbu uchovala v dokumentaci s konkrétní verzí pravidla. Další čtenář pak snáze pozná, zda důkaz stále odpovídá právě používané službě, nebo už popisuje její starší podobu.
Při hodnocení přínosu bych neposuzovala jen počet nalezených chyb. Brzké vyjasnění pravidla může zabránit vzniku závady, která se nikdy nezapíše do registru. Vedle počtů bych proto zachovala příklady rozhodnutí, která změnila návrh. Tím lze vysvětlit hodnotu prevence bez nepodloženého vyčíslování hypotetických škod nebo úspor, které jsme přímo nezměřili.