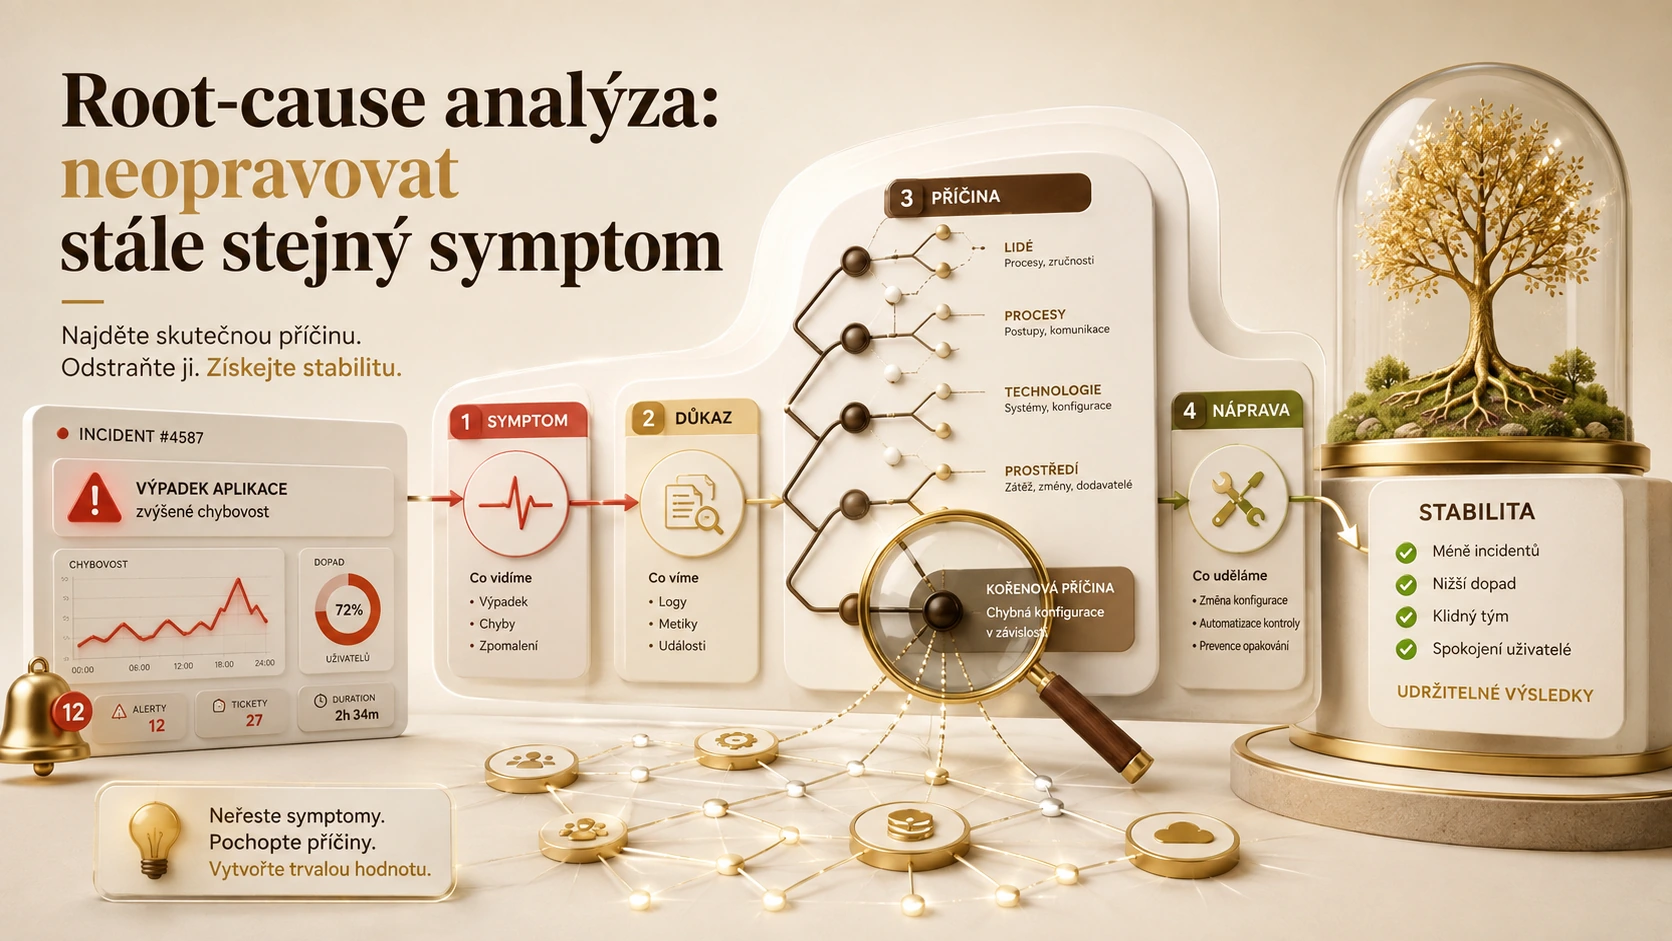
Obnovit službu a pochopit příčinu jsou dva úkoly
Když bankovní služba nefunguje, první prioritou je přiměřeně omezit dopad. Po obnově ale zůstává druhá práce: vysvětlit, proč problém vznikl a které podmínky dovolily jeho rozšíření. Rychlá oprava a analýza příčiny si nekonkurují. Mají jiný cíl i časový horizont. Pokud se spokojíme s tím, že systém opět odpovídá, nemusíme vědět, zda stejnou chybu nevyvolá další běžná změna.
Pojem kořenová příčina může svádět k hledání jediné odpovědi. V praxi bych očekávala spíše řetězec: technický spouštěč, nedostatečná kontrola, nejasná odpovědnost a okolnost, která ztížila obnovu. Oprava jednoho místa může být nezbytná, ale bez pochopení ostatních vazeb neposkytuje dostatečnou jistotu. Důležité je odlišit skutečně prokázanou příčinu od pravděpodobného vysvětlení.
Skutečný případ: RBS, NatWest a Ulster Bank, rok 2012
FCA dne 20. listopadu 2014 zveřejnila sankci za bankovní IT výpadky z června 2012. Popsala problém softwarové kompatibility a současně nedostatečné systémy a kontroly řízení IT rizika. Britský případ tak nabízí konkrétní rozlišení technického spouštěče a širšího kontrolního prostředí. Níže uvedená metodika je moje vlastní návrhová úvaha. [1]
Na takovém případu bych se neomezila na otázku, který soubor se změnil. Potřebovala bych vědět, jak byla posouzena kompatibilita, jak vypadal plán návratu a které příznaky odhalily skutečný rozsah. Neznalost konkrétního interního detailu bych nepřekrývala domněnkou. Veřejná zpráva dává výchozí fakta, nikoli oprávnění doplnit chybějící technický příběh podle představ.
Modelová situace: report přestal obsahovat část úvěrů
Uvažujme fiktivní měsíční export, v němž proti očekávání chybí 600 záznamů z celkových 30 000. Prvotní návrh je export spustit znovu. Pokud se po opakování všechny záznamy objeví, služba se zdánlivě obnovila. Samo opakování však nevysvětluje, proč první běh nebyl úplný. Nemusí ani prokazovat, že se mezitím nezměnila zdrojová data nebo časové vymezení.
Nejprve bych zachovala původní výstup, parametry a relevantní logy. Potom bych porovnala identifikátory chybějících záznamů a hledala společné vlastnosti. Mohlo by jít o jeden zdroj, časový interval, kategorii klienta nebo stav smlouvy. Takové seskupení je analytická stopa, ne hotový závěr. K hypotéze bych se snažila najít důkaz, který ji může také vyvrátit.
Jak bych sestavila časovou osu
Do časové osy bych zahrnula dostupnost zdrojových dat, spuštění úlohy, kontrolní body a vznik konečného souboru. Důležité jsou skutečné časy včetně časových pásem a zpoždění mezi systémy. Záznam „dokončeno“ může znamenat dokončení přenosu, nikoli potvrzení převzetí. Pokud jednotlivé týmy používají jiný význam události, může se příčina zdánlivě přesouvat mezi jejich systémy.
Každé tvrzení bych spojila s podkladem. Technický log má jinou sílu pro čas operace než vzpomínka účastníka. Současně ani log není neomylný, pokud nevíme, co zaznamenává nebo zda je úplný. Chybějící záznam může znamenat neprovedenou operaci, vypnuté logování nebo problém přenosu logů. Analýza musí udržet tyto možnosti oddělené, dokud se neověří.
Testovat hypotézy, ne jen potvrzovat první dojem
Představme si hypotézu, že export začal dříve než zdrojová dávka skončila. Hledala bych pořadí událostí a prověřila stejné chování v dalších dnech. Při bezpečné zkoušce bych porovnala běh s úplnými daty a běh s opožděným zdrojem. Nemusíme incident nebezpečně opakovat v produkci, abychom ověřili logiku závislosti. Zkouška má mít jasný rozsah a bezpečné prostředí.
Pokud hypotéza obstojí, stále bych se ptala, proč závislost nebyla vynucena nebo kontrolována. Časový plán může fungovat při obvyklé délce dávky, ale ne při zvýšeném objemu. Přidání patnácti minut do harmonogramu může krátkodobě pomoci, přesto nemusí být robustním řešením. Rozdíl mezi časovou rezervou a skutečnou kontrolou dokončení je důležitý pro další rozhodnutí týmu.
Nápravu spojit s mechanismem
U modelového exportu bych rozlišila okamžitou opravu výstupu, kontrolu dostupnosti vstupů a dlouhodobé řešení návaznosti. Každá položka má jiný účel. Pokud se po doplnění záznamů uzavře celý incident bez úkolu na závislost, může se problém vrátit. Pokud se naopak čeká jen na velkou architektonickou změnu, může zůstat nechráněný nejbližší měsíční běh.
Účinnost opatření bych ověřila i při neobvyklém průběhu. Co se stane, když dávka skončí chybou, nikoli pouze pozdě? Zastaví se export s jasným vysvětlením, nebo vytvoří neúplný soubor, který vypadá jako běžný výsledek? Bezpečné selhání a srozumitelná eskalace mohou být důležitější než snaha za každou cenu dokončit úlohu a ukázat zelený stav.
Co bych předala ostatním
Závěrečný zápis by obsahoval doložený průběh, mechanismus chyby, rozsah dopadu, zbytkovou nejistotu a opatření s vlastníky. U každého významného tvrzení bych uvedla, zda je prokázané nebo předpokládané. Tým potřebuje vědět také to, co analýza nepokrývala. Výrok o příčině jednoho exportu nesmí nechtěně vyznít jako potvrzení správnosti všech ostatních datových cest.
Nepoužívala bych formulaci „chyba obsluhy“ jako konečný výsledek. Zajímají mě podmínky, které chybný krok dovolily, a ochrany, které mohly jeho dopad omezit. Odpovědnost se tím neruší. Naopak je možné ji přesněji spojit s návrhem, schválením, provedením a kontrolou procesu místo obecného hledání viníka po události.
Shrnutí a doporučení
Dobrá analýza příčiny vysvětluje nejen co se pokazilo, ale proč to kontrolní prostředí nezachytilo nebo nezastavilo. Doporučila bych zachovat důkazy před opakováním operací, sestavit časovou osu a každou hypotézu cíleně zkoušet. Náprava má odpovídat mechanismu a obsahovat ověření neobvyklých i běžných situací.
Pro další čtení připojuji materiál Google SRE k incidentním rozborům. [2] Vlastní přínos bych viděla ve spojení technických detailů s dopadem na proces a srozumitelnou dokumentací. Smyslem závěru není odstranit veškerou nejistotu slovní formulací. Je jím umožnit týmu rozhodnout, co je potřeba udělat nyní, co změnit systémově a podle čeho později poznat účinnost nápravy.
Jak bych ověřovala účinnost po opravě
U modelové exportní dávky bych nestačila s důkazem, že opakovaný běh jednou vytvořil úplný soubor. Potřebovala bych odlišit obnovení dat od odstranění mechanismu chyby. Zkouška by proto zahrnovala pozdní vstup, přerušený vstup a běžné dokončení. V každé situaci musí být předem určeno očekávání: vytvoření úplného výstupu, bezpečné zastavení nebo srozumitelná eskalace. Bez tohoto rozlišení se zelená kontrolka může vztahovat jen na nejjednodušší průchod.
Při dalším pravidelném zpracování bych sledovala, zda se neopakuje ruční zásah, který opravu pouze napodobuje. Pokud pracovník před každým během opravuje příznak připravenosti, původní závislost zřejmě zůstala. Takový postup může být krátkodobě potřebný, měl by však mít vlastníka, omezené trvání a zřetelnou vazbu na trvalé opatření. Jinak se nouzové řešení postupně stane neviditelnou součástí běžné práce.
Závěrečný záznam bych předala také člověku, který incident neřešil. Pokud nedokáže z dokumentu určit, co se prokázalo, co bylo opraveno a které riziko zůstává, text ještě potřebuje úpravu. Přezkoumatelnost není jen formální požadavek na archiv. Chrání tým při dalším výskytu podobného příznaku, protože umožňuje rozpoznat stejný mechanismus i v jiném technickém prostředí. Zároveň brání automatickému použití starého vysvětlení tam, kde nyní důkazy ukazují jiným směrem.
Analýzu bych také časově ohraničila. Pokud se důkaz nepodaří získat, závěr musí přiznat zbytkovou nejistotu a určit další postup. Není užitečné donekonečna doplňovat jednu teorii bez možnosti ověření. Přiměřené dočasné opatření může chránit službu, zatímco cíleně připravené logování umožní při dalším výskytu získat chybějící rozlišující informace.