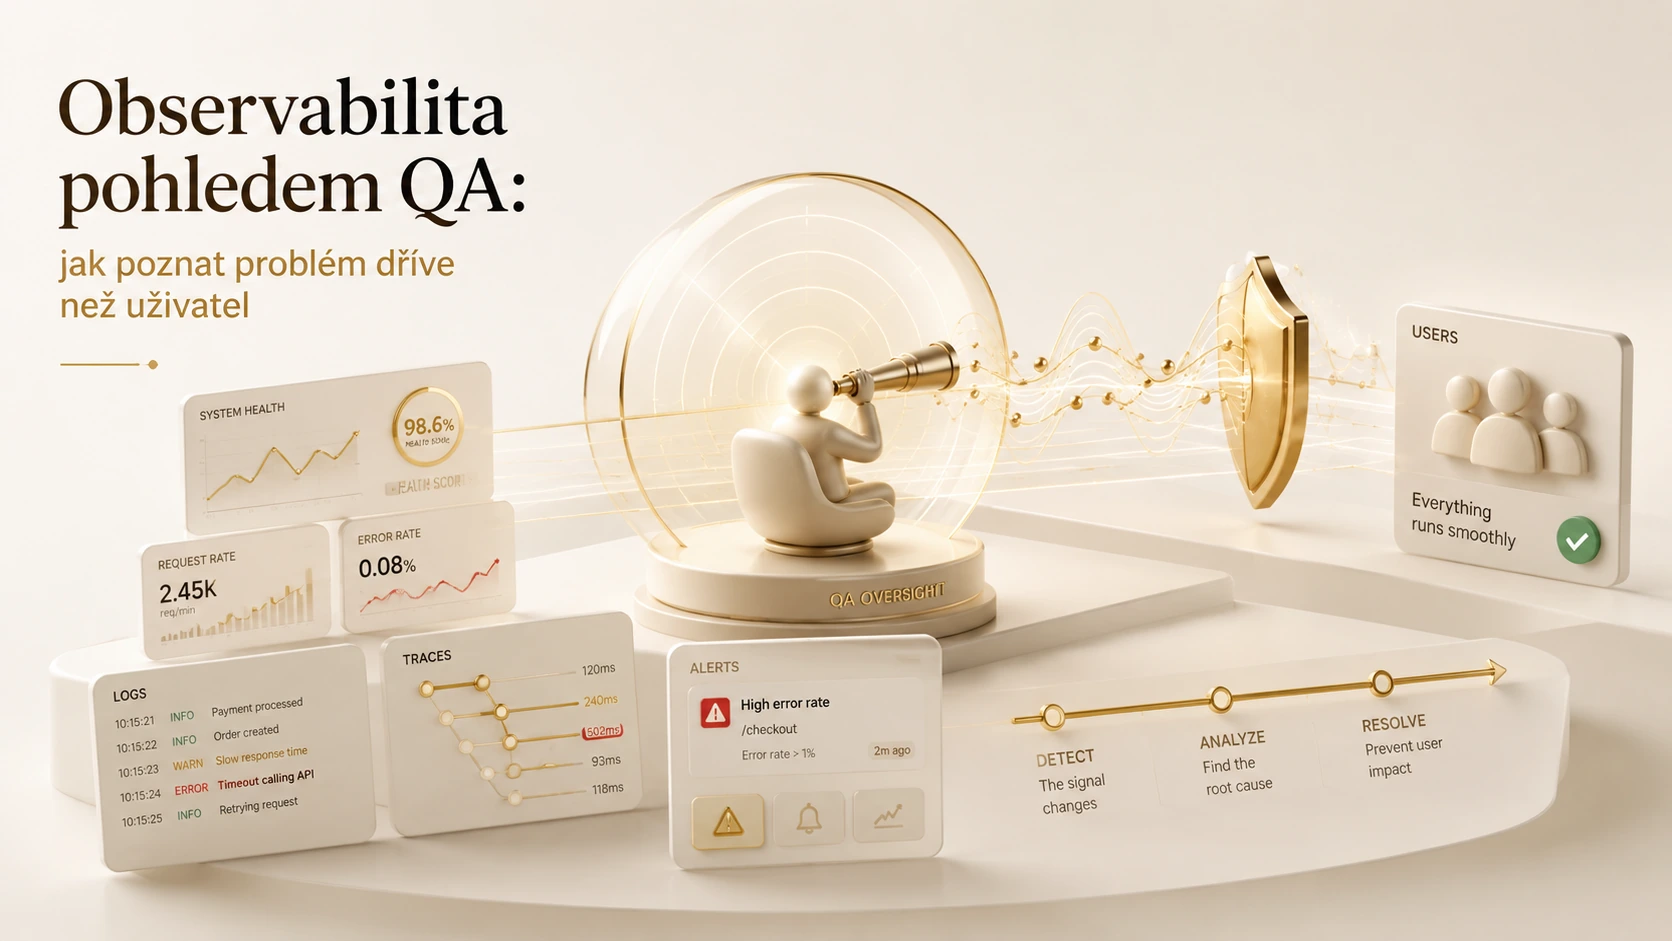
Proč je téma důležité
Systém může technicky běžet a přesto neposkytovat správnou službu uživateli. Server vrací odpověď 200, ale import zpracuje jen část záznamů. Proces skončí bez chyby, ale data nedorazí do cílového systému. Observabilita pomáhá pochopit vnitřní stav systému z jeho výstupů.
Z pohledu QA je důležité testovat nejen funkci, ale také to, zda systém umí své selhání včas a srozumitelně ukázat. Dobré logy, metriky a trace zkracují diagnostiku a snižují dobu dopadu.
Jak postupovat správně
Začněte kritickými uživatelskými cestami
Určete klíčové kroky a výsledek, který má uživatel obdržet. Technická dostupnost sama nestačí.
Používejte strukturované logy
Log má obsahovat čas, úroveň, službu, verzi, korelační ID a relevantní stav. Text bez struktury se obtížně hledá a porovnává.
Zaveďte korelační identifikátory
Jeden požadavek nebo dávka musí být dohledatelná napříč službami, frontami a databázemi.
Měřte technické i obchodní signály
Vedle latence a chybovosti sledujte počet dokončených importů, zpracovaných kampaní nebo neúspěšných validací.
Testujte alerty a runbooky
Simulujte selhání a ověřte, že alert přijde správnému týmu, obsahuje kontext a vede k použitelnému postupu.
Pracujte s rozpočtem šumu
Každý alert musí mít jasnou akci. Nadbytečné upozornění snižuje pozornost a může skrýt skutečný incident.
Čemu se naopak vyhnout
- Logování všeho bez struktury a bez otázky, kterou má log zodpovědět.
- Ukládání osobních nebo citlivých údajů do logů.
- Alertům bez vlastníka, priority a doporučeného postupu.
- Dashboardům s mnoha grafy, které nikdo pravidelně nepoužívá.
- Testování pouze technického statusu bez obchodního výsledku procesu.
Praktický příklad
Importní proces má korelační ID od nahrání souboru až po export validních kontaktů. Dashboard ukazuje počet přijatých, odmítnutých a dokončených dávek. Alert se spustí, pokud se dávka déle než deset minut neposune nebo pokud rozdíl počtů překročí stanovený práh.
QA při testu úmyslně způsobí chybu externí služby a ověří nejen chování aplikace, ale také log, trace, alert a informaci zobrazenou uživateli.
Ponaučení pro praxi
Observabilita je součást testovatelnosti. Kvalitní systém nejen funguje, ale také poskytuje dostatek bezpečných a srozumitelných důkazů, když fungovat přestane.
Skutečný případ: výpadek Cloudflare 21. června 2022
Cloudflare ve vlastním rozboru popsal výpadek po změně síťové konfigurace, která zasáhla devatenáct datových center. Událost začala 21. června 2022 v 06:27 UTC; obnovení všech dotčených míst firma uvedla v 07:42 UTC. Jde o provozní rozbor dodavatele, nikoli nezávislý audit. Dokládá však konkrétní situaci, při níž změna ovlivnila současně službu i možnosti její obnovy.
Moje úvaha je, že dostupnost dashboardu, aplikačního logu a vzdáleného přístupu může záviset na stejné infrastruktuře, která právě selhala. Když se testuje pouze vznik chybové zprávy v aplikaci, snadno unikne otázka, zda se k ní odpovědný člověk při skutečném výpadku vůbec dostane. Z tohoto případu nevyvozuji, že by konkrétní monitorovací nástroj firmě chyběl. Používám jej jako podnět pro testování celého řetězce od signálu k zásahu.
Modelový příklad: import úvěrových podkladů stojí
Modelový systém přijímá dávku 10 000 dokumentů. Počet přijatých záznamů roste, ale zpracování se zastaví po 3 000. Proces nevrací technickou chybu a přihlášení funguje. Kontrola dostupnosti tedy zůstává zelená, přestože uživatel čeká na výsledky, které nedostane. Čísla jsou ilustrativní; nepopisují žádnou banku ani událost Cloudflare.
Pro tento proces bych navrhla sledovat stáří nejstarší nezpracované položky, počet přijatých a dokončených záznamů a čas posledního skutečného posunu. Teprve jejich kombinace odliší pomalé zpracování velké dávky od zastaveného procesu. Mezní hodnotu bych neurčila nahodile: měla by vycházet z očekávané služby, typických objemů a času, který tým potřebuje k nápravě.
Jak bych testovala cestu od chyby k reakci
Nejprve bych se s provozem domluvila na bezpečném testovacím prostředí a přesném scénáři. Úmyslně bych vyvolala například timeout navazující služby a zaznamenala očekávaný signál. Zajímalo by mě, zda lze záznam spojit s konkrétní dávkou pomocí bezpečného identifikátoru, nikoli zda se v logu objeví osobní údaje klienta. Diagnostika má pomoci při dohledání problému a současně respektovat ochranu informací.
Potom bych sledovala, zda signál dorazí správné roli a zda je jeho význam srozumitelný. Upozornění „chyba služby“ je méně užitečné než informace, že konkrétní proces nepokračuje a jaký má očekávaný dopad. Součástí testu by bylo potvrzení převzetí, dostupnost pracovního postupu a možnost ověřit, že zásah opravdu obnovil zpracování. Zaznamenala bych časy, ne pouze výsledek splněno.
Negativní scénáře pro monitoring samotný
Vedle chyby aplikace bych zkoušela i výpadek sběru logů, ztrátu spojení s monitorovací službou a nesprávné hodiny. Chybějící data nesmějí automaticky znamenat bezchybný provoz. Pokud proces obvykle odesílá stav každou minutu, je důležitým signálem také to, že žádný stav nepřichází. Jiný scénář by ověřil, zda velké množství méně závažných upozornění nepřekryje jedinou kritickou informaci.
U distribuovaného procesu bych oddělila technické potvrzení přijetí od obchodního dokončení. Odpověď rozhraní může znamenat pouze zařazení do fronty, nikoli úspěšný zápis do cílového systému. Proto bych kontrolovala konečný stav z pohledu uživatele a teprve poté technické mezikroky. Takové uvažování pomáhá i při analýze bankovních reportů, kde korektní přenos zprávy ještě nezaručuje správný obsah výsledku.
Vyhodnocení a předání
Výsledkem by byla mapa: jaké selhání jsme simulovali, jaký důkaz vznikl, kdo jej obdržel a jaký krok následoval. Pokud některý článek chybí, má tým konkrétní úkol. Ne každá nalezená mezera znamená nutnost nového nástroje. Někdy stačí doplnit vazbu na běžný proces, jasnou odpovědnost nebo nezávislý kontrolní signál. Nástroj bych vybírala až po pojmenování otázky, kterou potřebujeme zodpovědět.
Jak bych testovala samotnou viditelnost chyby
Pro každý významný negativní scénář bych kromě očekávaného chování aplikace popsala také očekávaný diagnostický výsledek. Kdo má poznat, že problém nastal? Z jakého signálu? Jak odliší jednu neúspěšnou operaci od celé nedostupné služby? Bez těchto odpovědí může test potvrdit správnou chybovou hlášku a přesto ponechat provozní tým bez potřebných informací. Můj návrh proto zahrnuje ověření návaznosti mezi zákaznickým projevem, technickým signálem a konkrétním postupem reakce.
V hypotetickém testovacím prostředí bych například vyvolala zpoždění odpovědi navazující služby. Ověřila bych nejen časový limit a srozumitelnost zprávy, ale také to, zda se jedna operace nevykazuje jako několik nezávislých zákaznických selhání. Při opakování požadavku bych sledovala, zda lze původní a další pokus propojit. Účelem není vyrobit co nejvíce záznamů. Potřebuji takové údaje, které umožní určit rozsah dopadu a další bezpečný postup. Citlivé vstupy bych pro tento účel nahrazovala vhodnými testovacími daty.
Vyhodnocení bych provedla s člověkem, který bude skutečně držet provozní službu. Předala bych mu pouze běžně dostupné podklady a sledovala, zda dokáže určit další krok bez ústního vysvětlování autora testu. Pokud musí hádat význam názvu události nebo hledat neexistující odkaz, je to konkrétní nedostatek k opravě. Po změně bych stejnou situaci zopakovala a porovnala srozumitelnost výsledku. Takto bych ověřovala použitelnost diagnostiky, nikoli jen přítomnost nástroje. Do závěru bych zaznamenala i zbývající slepá místa, aby následný tým nepředpokládal širší pokrytí, než jaké test skutečně prokázal.
Shrnutí a doporučení
Observabilita pro mě znamená schopnost porozumět skutečnému průběhu služby na základě dostupných důkazů. Doporučuji testovat nejen detekci chyby, ale i doručení, převzetí a ověření nápravy. Sledovat obchodní dokončení vedle technické dostupnosti a považovat chybějící signál za samostatný stav. Dobrá kontrola pomůže člověku správně jednat právě tehdy, když systém nefunguje běžným způsobem.