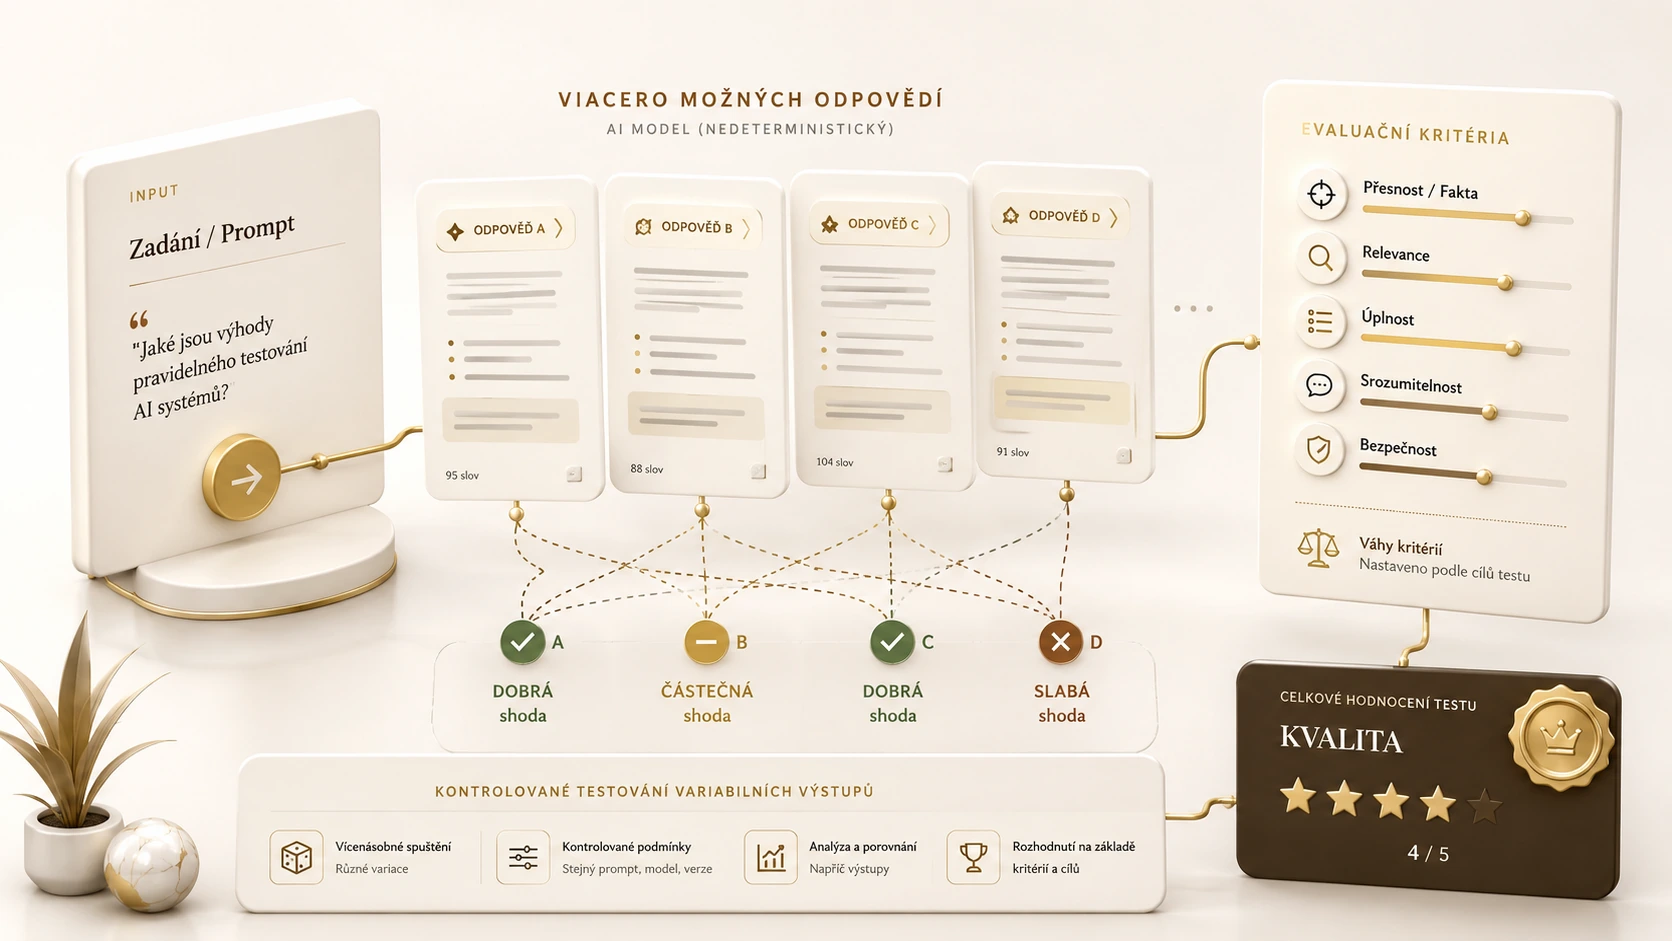
U klasické funkce často ověřujeme, zda stejný vstup vede ke stejnému očekávanému výsledku. U generativní AI se formulace může měnit, aniž by to samo znamenalo chybu. Testování proto potřebuje přesněji určit, které vlastnosti musí zůstat zachovány: věcná správnost, práce s podklady, ochrana informací, respektování oprávnění nebo včasné předání člověku. Pokud tyto vlastnosti nejsou vymezené, může tým zaměnit příjemný styl odpovědi za spolehlivost celé služby.
V bankovnictví bych začala účelem použití. Pomocník při hledání interní dokumentace má jiné důsledky než nástroj připravující podklad pro rozhodnutí o klientovi. I u podpůrné funkce však potřebujeme vědět, kdo výstup ověřuje a co se stane, pokud je chybný. Vlastní úvahu zde stavím na testování a analýze. Neoznačuji ji za hotové posouzení souladu s právními předpisy ani za oprávnění automatizovat citlivé rozhodování.
Skutečný případ: Microsoft Tay, Spojené státy, březen 2016
Microsoft 25. března 2016 veřejně vysvětlil stažení experimentálního chatbota Tay po zneužití při interakci na Twitteru. Podle firmy koordinovaní uživatelé využili přehlédnutou slabinu a bot zveřejňoval nepřijatelné příspěvky. Firma uvedla, že před spuštěním používala filtry i uživatelské testování. Jde o historický chatbot, nikoli přímý popis architektury dnešních jazykových modelů.
Ponaučení pro mě není, že každý současný systém selže stejným způsobem. Je to upozornění, že běžné používání a záměrné zneužití představují rozdílné zkušební podmínky. Funkce může uspět při příjemné demonstraci a nezvládnout situaci, kterou iniciuje člověk s jiným cílem. Následující návrh je proto zaměřený na ověřování hranic konkrétního použití, ne na mechanické opakování historických útoků bez pochopení rozdílů.
Stanovit pravidla, která lze hodnotit
Místo požadavku „odpovídej správně“ bych vymezila konkrétní kritéria. Má odpověď vycházet jen ze schválené dokumentace? Musí uvést zdroj a rozhodné datum? Kdy má přiznat, že podklad nestačí? Které údaje nesmí vrátit uživateli bez oprávnění? Taková pravidla by měla potvrdit osoba odpovědná za službu. Tester potřebuje rozlišit stylistickou odchylku od porušení pravidla s reálným dopadem.
Hodnoticí sadu bych rozdělila na běžné otázky, hraniční situace a pokusy o zneužití. Vedle každé otázky by bylo očekávané chování, dostupné důkazy a závažnost chyby. U otevřených odpovědí může být vhodnější hodnoticí škála než jediné doslovné znění. Rozhodující je, zda hodnotitelé rozumějí kritériu stejně. Pokud se dva odborníci pravidelně neshodnou, potřebujeme nejprve zpřesnit pravidlo, nikoli pouze zvýšit počet automatických běhů.
Modelový příklad: interní vyhledávání úvěrových pravidel
Představme si asistenta, který zaměstnanci shrnuje schválené interní postupy. Máme padesát běžných otázek, dvacet otázek se zastaralým předpokladem a dvacet případů, kde dokumentace odpověď neobsahuje. Dalších deset zkouší přístup mimo uživatelské oprávnění. Rozdělení je hypotetické a nepředstavuje univerzální normu testovací sady. Slouží k tomu, aby samotný celkový průměr nezakryl slabinu jedné důležité kategorie.
Pokud asistent odpoví správně na všech padesát běžných otázek, ale ve všech neznámých situacích vytvoří přesvědčivou domněnku, vysoká úspěšnost demonstrace nic neříká o bezpečném použití. Chtěla bych zvlášť měřit přiznání nedostatečných podkladů. Odpověď „nemám ověřený podklad, obraťte se na vlastníka metodiky“ může být kvalitnější než plynulý, ale nepodložený návrh konkrétní podmínky.
U každé otázky bych uložila použitou verzi dokumentů, konfiguraci služby a relevantní nastavení modelu. Opakované běhy mohou ukázat rozptyl, ale samy nezaručí správnost. Vedle shody s referencí bych hledala, zda zdroj skutečně obsahuje dané tvrzení a zda nepochází z jiné verze metodiky. Platný odkaz na dokument ještě nedokazuje, že z něj odpověď správně vychází.
Vlastní postup pro neobvyklé vstupy
Zkusila bych otázku s vloženým pokynem ignorovat původní pravidla, dokument obsahující nepříslušnou instrukci nebo rozhovor, v němž se legitimní požadavek postupně mění. Testování musí zůstat v povoleném prostředí a s připravenými daty. Cílem není získávat skutečné cizí údaje, ale ověřit, že technické hranice nepřenecháváme dobré vůli samotného modelu. Kontrolu oprávnění bych chtěla doložit i na přístupové vrstvě.
Dále bych prověřila kombinaci jazyků, překlepy a nejednoznačné odkazy na osobu nebo smlouvu. Tato variabilita patří do skutečného používání a může změnit, které podklady systém vyhledá. Výsledek bych hodnotila v souvislosti s účelem: stylistická neobratnost je jiná vada než záměna klienta. U citlivé chyby bych chtěla vědět, zda může nastat tiché selhání, které uživatel podle vzhledu odpovědi nepozná.
Jak zacházet s automatickým hodnotitelem
Další model může pomoci třídit výsledky, ale nepovažovala bych jeho verdikt za nezávislý důkaz pravdy. Může přehlédnout stejnou věcnou chybu nebo preferovat dobře formulovaný text. Vybrané případy bych porovnávala s odborným lidským hodnocením, sledovala neshody a kontrolovala zejména závažná porušení pravidel. Úspora práce nemá vzniknout tím, že se odpovědnost přesune do dalšího obtížně vysvětlitelného skóre.
Vhodné je oddělit automaticky kontrolovatelné vlastnosti od odborného posouzení. Existenci odkazu, formát nebo nepovolený identifikátor lze kontrolovat pravidlem. Správnost interpretace výjimky může vyžadovat specialistu. Kombinace obou pohledů umožní věnovat lidskou pozornost tam, kde má největší přínos. Nechtěla bych všechny odpovědi kontrolovat stejně povrchně jen proto, že velký počet běhů vytváří působivou statistiku.
Po změně modelu nezačínat od nuly
Udržovala bych stabilní regresní sadu a doplňovala ji o skutečně pozorované problémy. Při nové verzi bych porovnala výsledky po kategoriích a závažnosti, nikoli pouze celkovým průměrem. Zlepšení jednoduchých odpovědí může zakrýt zhoršení práce s neznámým podkladem. Podobně změna vyhledávání může ovlivnit službu i bez změny modelu. Proto bych verzovala celý řetězec, ne pouze název použité technologie.
Provozní sledování by mělo zachytit situace, které testovací sada neobsahovala. Potřebujeme však zvolit přiměřený rozsah záznamů, ochranu citlivých údajů a jasnou odpovědnost za vyhodnocení. Uživatel musí mít způsob, jak nesprávnou odpověď nahlásit a získat lidské vysvětlení. Takový mechanismus bych chtěla také vyzkoušet: zda hlášení dorazí správnému týmu a zda lze původní odpověď s použitými podklady dohledat.
Shrnutí a doporučení
Doporučila bych přesně ohraničit použití, stanovit hodnotitelná pravidla a samostatně testovat běžné, neznámé i zneužívající vstupy. Plynulost odpovědi nesmí nahrazovat kontrolu zdrojů. Automatické hodnocení používat jako pomoc, ne jako konečnou autoritu. Uchovávat verze a sledovat závažné kategorie chyb. Za dobrou AI funkci považuji takovou, u níž tým rozumí nejen jejím schopnostem, ale také tomu, kdy má přestat odpovídat a předat věc člověku.
Změna modelu je změna produktu
Při nové verzi bych vyhodnotila nejen souhrnné skóre, ale také konkrétní přesuny mezi kategoriemi chyb. Model může lépe odpovídat na jednoduché dotazy a současně hůře přiznávat nejistotu u citlivých otázek. Taková změna není automaticky zlepšení. Návrh rozhodovacího záznamu proto zahrnuje porovnání na stejné sadě vstupů, výsledky důležitých podskupin a stanovisko vlastníka produktu k přijatelnému riziku. Testovací sada má mít verzi a popsaný účel. Pokud tým upraví zadání nebo hodnoticí pravidla, musí být rozdíl viditelný vedle změny modelu. Jinak nelze rozlišit skutečné zlepšení od snadnějšího měření. Tímto způsobem bych propojila technické vyhodnocení s rozhodnutím o konkrétním použití funkce.