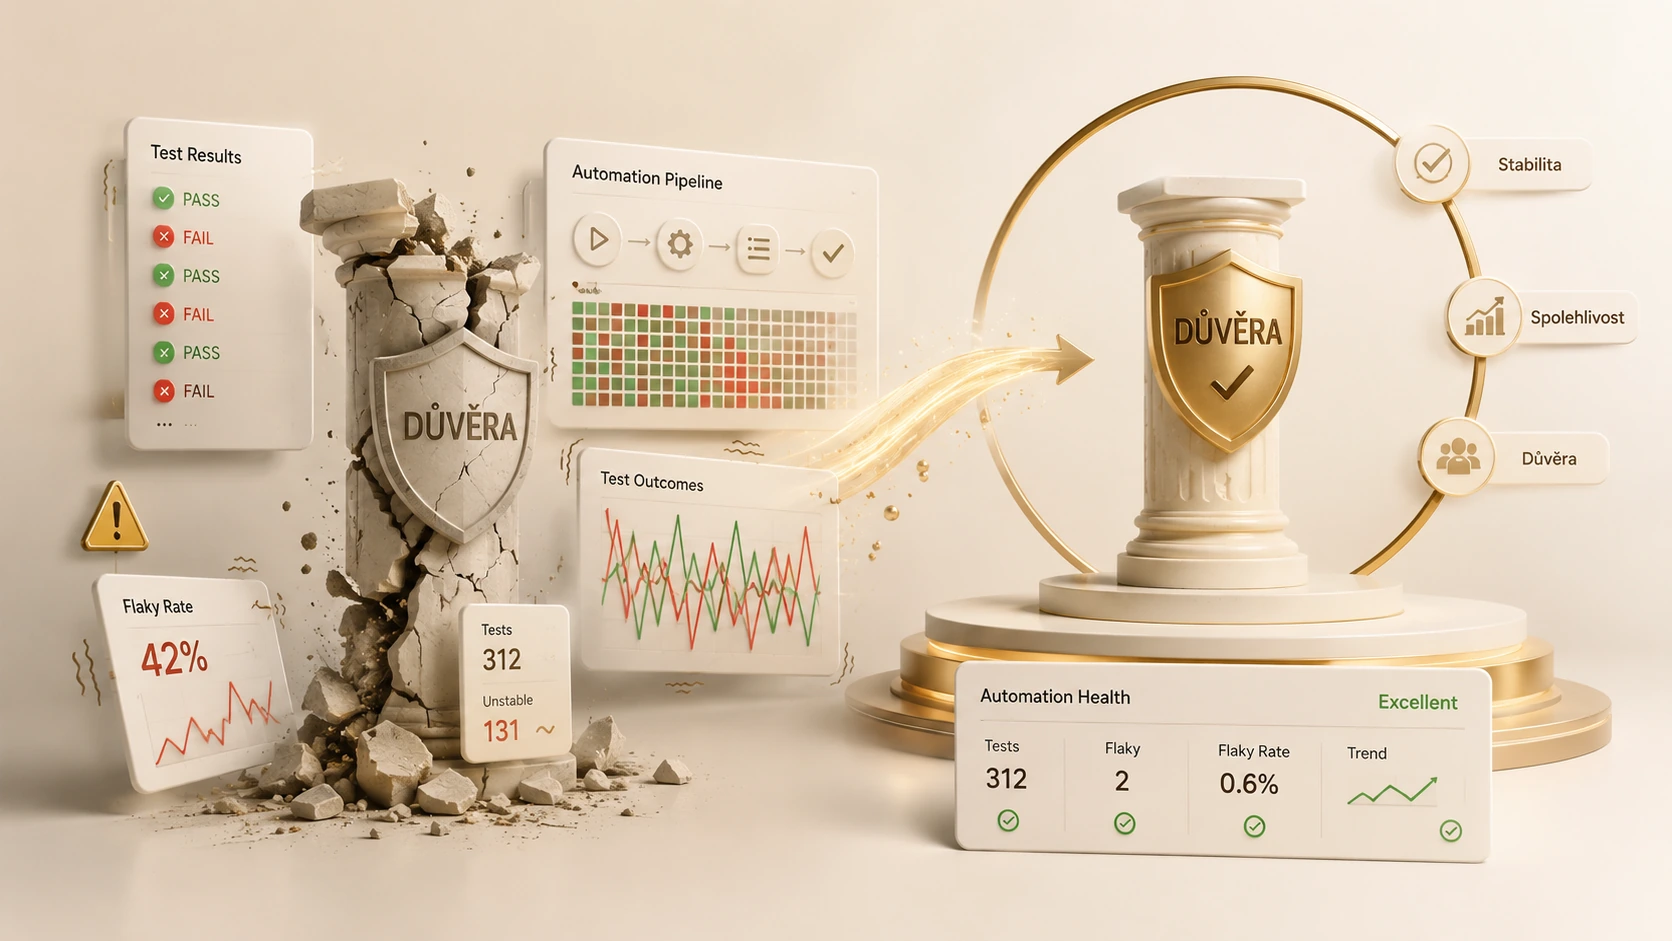
Test má pomáhat rozhodnout, zda změna něco poškodila. Pokud při stejném kódu jednou projde a podruhé selže, jeho výsledek se stává obtížně použitelným. Problém není jen v několika minutách čekání na opakovaný běh. Tým se učí, že červený výsledek nemusí nic znamenat, a může přehlédnout skutečnou regresi. Takzvaný flaky test proto vnímám jako závadu testovacího systému, kterou je potřeba vyšetřit a řídit stejně věcně jako jinou chybu.
V bankovní nebo datově citlivé aplikaci může nestabilita zkomplikovat ověření plateb, importů či výpočtů. Není však správné automaticky obvinit samotný test. Nepravidelná chyba může odhalovat skutečný problém produktu, například souběh dvou operací nebo nezvládnutou obnovu spojení. Než selhání označím za šum, chci porozumět tomu, které podmínky se mezi běhy změnily a zda je očekávané chování skutečně jednoznačné.
Skutečná zkušenost: Google, květen 2016
Google ve svém vývojářském blogu 27. května 2016 popsal flaky výsledky přibližně u 1,5 procenta testovacích běhů a alespoň určitou nestabilitu u téměř 16 procent testů. Jde o historická interní pozorování této firmy, nikoli o obecnou normu nebo dnešní hodnotu pro všechny projekty. Zpráva také upozorňuje na ztrátu důvěry v opakované falešné poplachy.
Pro můj postup je inspirací především rozhodovací problém. Když tým při každém červeném běhu očekává falešný poplach, nemusí včas poznat novou vadu. Z uvedených procent ale nelze odvodit, kolik nestabilních testů je přijatelné v jiné aplikaci. Potřebovala bych vlastní historii výsledků, význam chráněných funkcí a délku vyšetřování. Následující návrh je moje pracovní úvaha, ne přepis současného interního postupu Googlu.
Co bych měřila místo dojmu
Začala bych evidencí testu, verze kódu, prostředí, času, vstupních dat a typu selhání. Samotný součet neúspěšných běhů nerozlišuje změnu produktu od nestability. Zajímaly by mě přechody mezi úspěchem a neúspěchem při stejných vstupních podmínkách. Výsledek bych členila podle testovací sady a závislosti, aby se nestabilita jednoho přetíženého prostředí nezaměnila za nezávislé vady deseti funkcí.
Potřebovala bych zachovat důkazy z prvního selhání ještě před opakováním. Prohlížečová trace, log služby, identifikátor požadavku a časová osa mohou obsahovat informaci, která v dalším běhu zmizí. Opětovné spuštění má diagnostickou hodnotu, ale nemělo by přepsat původní výsledek bez stopy. Report by měl ukázat, že první pokus selhal a druhý prošel, nikoli předstírat nepřerušený úspěch celého sestavení.
Modelový příklad: souběžné vytváření kampaně
Představme si sto kontrolovaných běhů scénáře, který vytvoří kampaň a následně ji hledá v seznamu. Dvanáct běhů selže na nalezení řádku, přestože služba vytvoření potvrdila. Testy současně používají stejný účet a stejné jméno kampaně. Čísla i systém jsou hypotetické. Nejprve bych rozlišila, zda vzniká problém čekání na obnovu seznamu, kolize dat, nebo skutečně ztracený záznam.
Pevné přidání deseti sekund může některá selhání skrýt, ale nevysvětlí příčinu. Použila bych vrácený identifikátor vytvořené kampaně a sledovala konkrétní stav. Každý běh by získal vlastní rozlišitelná data a bezpečný úklid. Pokud seznam aktualizuje asynchronní proces, čekala bych na doložitelnou podmínku s rozumným časovým limitem. Nepředpokládala bych, že pomalejší zobrazení je automaticky přijatelné; očekávanou odezvu musí potvrdit požadavek.
Následně bych odděleně zkusila sériový a paralelní běh. Jestliže selhání mizí jen při sériovém zpracování, je to vodítko pro zkoumání sdílených stavů, nikoli definitivní důkaz vady testu. Mohu také odhalit skutečný souběžný problém produktu. Proto bych změnu izolace dat a opravu čekání vyhodnocovala postupně. Pokud upravím obě věci najednou, bude obtížnější doložit, které opatření problém řeší.
Jak bych stanovila prioritu a dočasný režim
Test platebního schválení s opakovaným nejasným výsledkem má jiný význam než kosmetická kontrola méně důležité stránky. Prioritu bych určovala podle dopadu chráněného chování, četnosti selhání a nákladů na diagnostiku. Kritická funkce potřebuje spolehlivou náhradní kontrolu, pokud její automatizovaný scénář dočasně vyřadíme z rozhodovací brány. Vyřazení samo o sobě neznamená, že riziko zmizelo nebo že se za správnost může někdo zaručit.
Dočasná karanténa by měla mít vlastníka, popis příčiny nebo otevřené hypotézy, náhradní ověření a termín přehodnocení. Test by se dál spouštěl pro sběr informací, jen by byl jasně oddělen jeho rozhodovací účinek. Nechtěla bych vznik trvale ignorovaného seznamu, který roste bez kontroly. Pravidelně bych porovnávala nové přírůstky a skutečně opravené případy, aby se problém neztratil v celkovém počtu testů.
Opravu ověřit za podmínek, které chybu vyvolávaly
Po úpravě bych zopakovala původní podmínky, nikoli pouze jeden náhodný úspěšný běh. Pokud se chyba projevovala při souběhu, ověřovala bych souběh. Pokud závisela na časovém pásmu nebo přelomu dne, zahrnula bych odpovídající kombinace. Nulový počet selhání v omezeném vzorku však není matematickým důkazem absolutní stability. Výsledek bych popsala s rozsahem a pokračovala v běžném sledování.
Zajímal by mě také čitelný důvod budoucího selhání. Test může být stabilní, ale při problému vrátit jen obecný timeout. Doplnila bych kontrolní body, které odliší nepřijatý požadavek, nedokončené zpracování a nezobrazený výsledek. Tím se zkracuje diagnostika příští vady a snižuje potřeba ručního opakování. Kvalita testu zahrnuje i kvalitu informace, kterou tým dostane, když aplikace skutečně přestane fungovat podle očekávání.
Co bych chtěla probrat s vývojáři
Na společném rozboru bych se ptala na sdílené účty, globální konfiguraci, fronty, časování a způsob úklidu testovacích dat. Cílem není určit viníka. Potřebuji zjistit, která závislost se mezi běhy mění a zda ji máme pod kontrolou. U externí služby bych odlišila nestabilitu integračního prostředí od chování skutečného produktu. Simulátor může zrychlit izolované ověření, ale nezastupuje všechny integrační vlastnosti živé služby.
Výsledek bych předala jako ověřitelnou změnu: co bylo původně pozorováno, co se upravilo a jaké podmínky byly znovu vyzkoušeny. Pokud se příčinu nepodaří určit, řekla bych to otevřeně a uvedla zbývající hypotézy. Není užitečné uzavřít problém jako opravený pouze proto, že se několik dnů neobjevil. U vzácné chyby může právě krátké sledované období vytvářet neoprávněný pocit jistoty.
Shrnutí a doporučení
Doporučila bych uchovávat první selhání, měřit nestabilitu v konkrétních podmínkách a opravovat příčinu namísto automatického opakování. Prioritu spojit s rizikem chráněné funkce. U dočasně vyřazeného testu určit náhradní kontrolu a termín návratu. Důvěra vzniká, když tým ví, co červený výsledek znamená, jak jej vyšetřit a jaké omezení zůstává. Počet zelených ikonek sám o sobě tuto jistotu neposkytuje.
Kdo ověřuje návrat testu
Návrat z karantény by podle mého návrhu neměl záviset jen na počtu zelených běhů. Oprava potřebuje vysvětlení mechanismu nestability a důkaz, že nový test skutečně rozlišuje správné a chybné chování. U souběhu například nestačí prodloužit čekání: vhodné je řídit pořadí událostí a ověřit skutečnou podmínku dokončení. Recenzent může zkontrolovat také to, zda oprava neoslabila původní tvrzení. Test, který už nic podstatného neověřuje, není úspěšně opravený. U každého zásahu bych zaznamenala původní příčinu, změnu a zbývající omezení. Tak vzniká využitelná znalost pro další týmy a zároveň podklad pro rozhodnutí, zda má test dál patřit do rychlé blokující sady.